写于
opencode-models-discovery 1.4.0:增强模型的元数据注入与性能优化
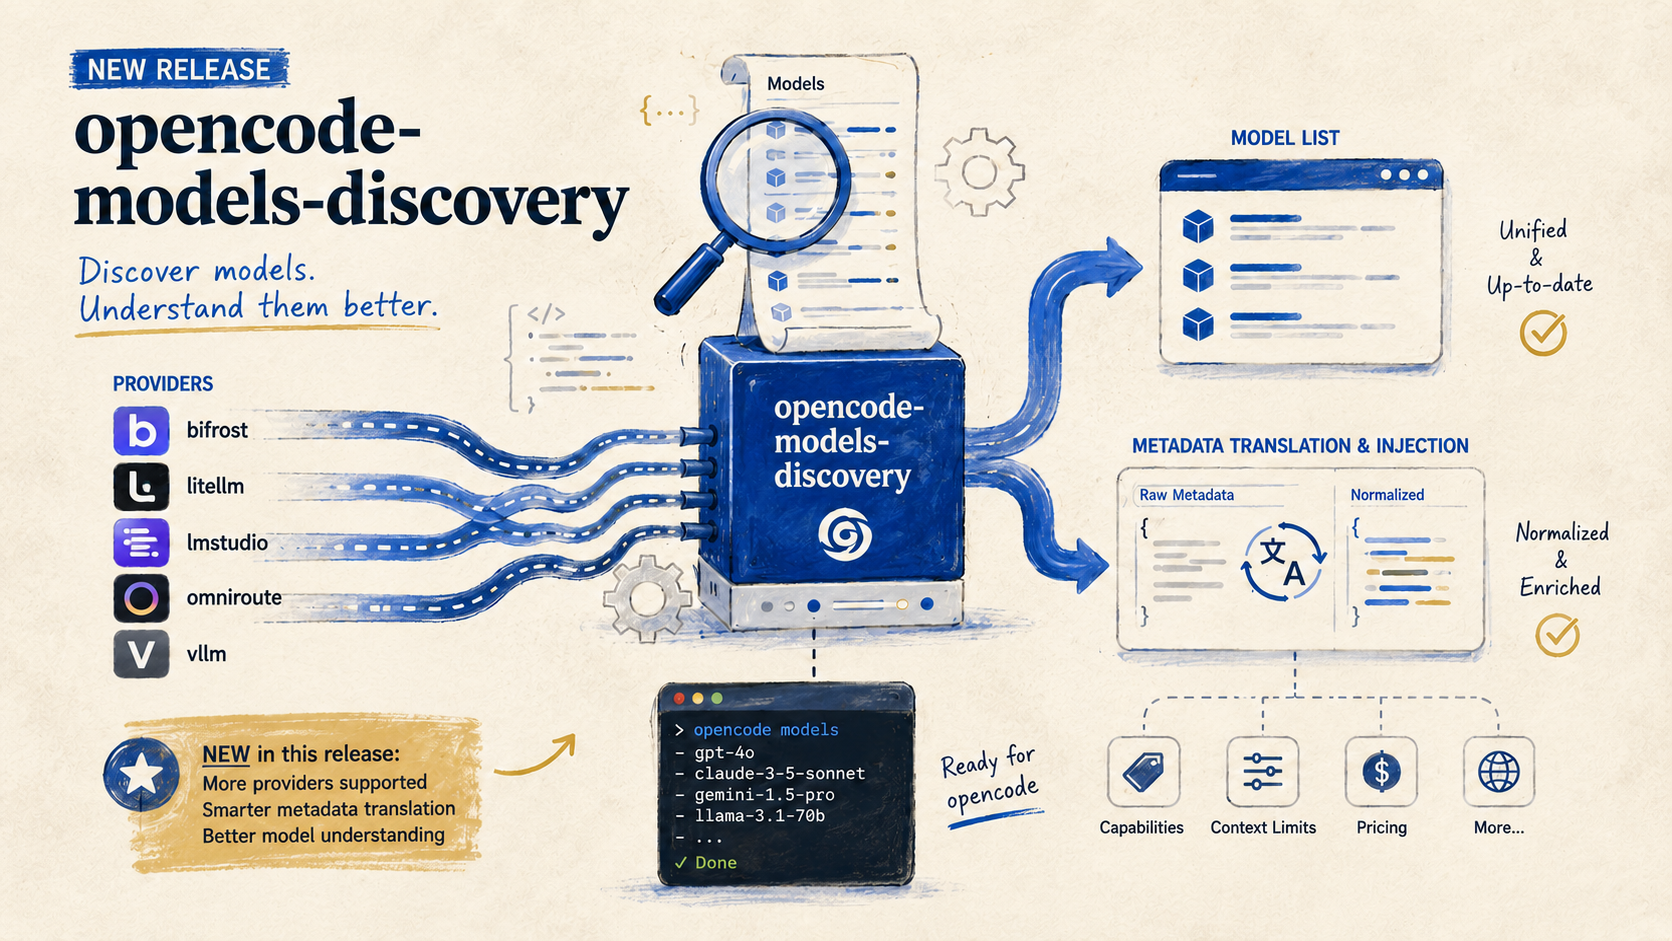
从 1.0.0 到 1.4.0,opencode-models-discovery 新增多种 provider 元数据增强,并通过缓存、超时控制和显式配置合并,让 OpenCode 的动态模型发现更完整、更稳定。
语言:English
一个多月前,opencode-models-discovery 正式发布了 v1.0.0。
感谢社区的贡献与反馈,项目已经到了 v1.4.0 版本。
从 v1.0.0 到今天的 v1.4.0,项目的改进点,主要聚焦在不同提供商的模型元数据增强上,顺便加上了缓存机制与超时控制改善使用体验。
以明确的配置方式启动模型元数据注入机制
许多 OpenAI 兼容服务的 /v1/models 只返回模型 ID。对于 OpenCode 来说,ID 只是起点:上下文窗口、输出上限、图像或音频模态、工具调用、推理、结构化输出,以及价格信息,都会影响模型在界面中的呈现和实际可用能力。
但这些信息没有统一的 OpenAI 兼容扩展标准。不同服务把它们放在不同的端点、字段和数据格式中。插件如果盲目猜测,反而可能把不支持的能力标给模型;如果只读取最标准的字段,用户则仍要为每个模型补写大量配置。
因此,opencode-models-discovery 采用了一个明确的边界:基础发现始终使用通用的模型列表接口;只有在 provider 上显式启用特定格式时,才读取和映射该 provider 的扩展元数据。取不到或无法安全匹配时,模型发现仍会成功,未知能力保持未知。
从 1.0.0 到 1.4.0:新增四种模型元数据增强
1.0.0 已支持通过 models.dev 公共索引,或 LiteLLM 的模型信息接口补齐模型能力。到 1.4.0,插件新增了四种按 provider 选择的 enrichment 模式:
vllm:读取/v1/models中非标准的max_model_len,补齐上下文与输出限制;没有该字段时仍保留基础发现。lmstudio:在标准发现后读取 LM Studio 原生的/api/v1/models库存,补齐显示名称、视觉、工具调用、推理、变体和上下文。LM Studio 不报告独立输出上限,因此不会把上下文长度错误地当作输出限制。bifrost:直接解释 Bifrost/v1/models的内联元数据,映射 token 限制、输入输出模态和价格,并将SPEECH等值规范化为 OpenCode 可识别的形式。omniroute:直接解释 OmniRoute/v1/models的内联元数据,补齐上下文与 token 限制、模态、附件、推理、工具调用、结构化输出及温度支持;缺少输入模态时,会以capabilities.vision作为图像输入的后备信息。
下面以 LM Studio 0.4.0+ 为例。插件仍通过标准接口发现模型,再读取其原生库存补齐能力信息:
{
  "$schema": "https://opencode.ai/config.json",
  "plugin": ["opencode-models-discovery@latest"],
  "provider": {
    "lmstudio": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "LM Studio (local)",
      "options": {
        "baseURL": "http://127.0.0.1:1234/v1",
        "modelsDiscovery": {
          "enabled": true,
          "modelInfoFormat": "lmstudio"
        }
      }
    }
  }
}
截至 v1.4.0,可显式选择的元数据格式包括 bifrost、litellm、lmstudio、models.dev、omniroute 和 vllm。它们是按 provider 独立配置的:同一份 OpenCode 配置可以让本地 LM Studio、远端网关和其他兼容服务各自使用适合的数据来源。
当前支持的 enrichment 方式速查
下表列出目前可用于补齐原始模型列表数据的 gateway、运行时和元数据提供商。除了 models.dev 外,其余格式都针对你已经配置的 OpenAI 兼容 provider;并非自动探测到某个网关后就会启用,仍需通过 modelInfoFormat 明确选择。
| 配置值 | 适用 gateway / 数据源 | 元数据来源 | 可补齐的主要信息 |
|---|---|---|---|
bifrost | Bifrost AI 网关 | 内联 | 上下文、输入/输出上限、模态、输入/输出价格;启用 smartModelName 时使用规范化名称 |
litellm | LiteLLM 网关/代理 或兼容的模型信息服务 | 外部 | token 限制、推理支持与推理强度变体;默认跳过非 chat 模型 |
lmstudio | LM Studio 引擎 (版本要求:0.4.0+) | 外部 | 显示名称、上下文、视觉、工具调用、推理与推理变体 |
omniroute | OmniRoute AI 网关 | 内联 | 上下文与 token 限制、模态、附件、推理、工具调用、结构化输出、温度支持 |
vllm | vLLM 或返回 vLLM 字段的兼容服务 | 内联 | 上下文与输出限制;不推断模态、工具或推理能力 |
models.dev | 公共 models.dev 元数据索引,适合能安全匹配的通用模型 | 外部 | token 限制、附件、推理、工具调用、结构化输出、温度和模态等 |
所有方式在缺少字段、请求失败或匹配不确定时都会保留基础发现结果,而不会猜测能力。
利用缓存机制提升 OC 的启动速度
对于本地服务,一次模型列表请求通常很快;但经过远端网关、多个 provider 或额外元数据接口后,OpenCode 启动时的重复发现也会变得可感知。
v1.2.0 因此加入 provider 级的持久缓存。启用后,插件会保存一次成功完成过滤和元数据增强后的模型配置。在 TTL 有效期内重新启动时,它直接注入缓存结果,不再请求模型列表、不再解析凭据,也不再重复发起元数据增强请求。
{
  "modelsDiscovery": {
    "enabled": true,
    "cache": {
      "enabled": true,
      "ttlSeconds": 86400
    }
  }
}
缓存按 provider 隔离,并校验 provider ID、规范化后的 base URL、模型 endpoint、配置结构版本和 TTL。缓存文件存放在插件自己的 XDG 数据目录,不包含 API Key、认证头或 OpenCode/MiMoCode 的认证数据;失效、损坏、不可读或不可写时,插件会自动回退到实时发现,而不是阻塞启动。
缓存也可以保留单个模型的持久化覆盖项,适合保存少数人工确认过的能力或变体配置。它们与插件生成的缓存数据分开保存,避免一次刷新覆盖掉用户的定制。
让我们等一等响应比较慢的提供商
有些本地服务器刚启动时响应很慢,部分网关的模型目录也可能比默认等待时间更久。v1.3.1 增加了 provider 级 timeoutMs,默认值为 3000 毫秒:
{
  "modelsDiscovery": {
    "timeoutMs": 15000
  }
}
这个设置同时作用于该 provider 的模型列表和 provider 专属元数据请求。OpenCode 启动时默认会为发现预留 5000 毫秒;只有某个 provider 配置的 timeoutMs 更大时,插件才会相应提高等待预算,让确实需要更长时间的发现请求有机会在启动继续前完成,同时避免所有 provider 无限等待。
显式配置项不再被覆盖
动态发现解决“模型有哪些”,但用户仍常常需要对其中某一个模型补充自己的偏好,例如添加一个高推理强度的 variant,或填写 provider 特有的 options。
此前,如果模型既被发现、又出现在 provider.<id>.models 中,部分显式配置可能会使已有的名称、限制、模态或能力元数据丢失。v1.4.0 调整了组装顺序:匹配到的显式模型配置会递归合并到发现或缓存得到的模型之上。
{
  "provider": {
    "gateway": {
      "models": {
        "example-model": {
          "variants": {
            "high": {
              "reasoningEffort": "high"
            }
          }
        }
      }
    }
  }
}
嵌套对象会合并,数组和标量则由显式值替换;模型 ID 仍以发现结果为准。未被发现的显式模型依旧可以单独存在。无论模型来自实时发现还是一份有效缓存,这套规则都相同,且显式配置不会被写回插件缓存。
换句话说,自动发现和手动控制不再是二选一:插件负责维护会变化的公共事实,用户只需要维护少量真正属于自己的差异。
一条更清晰的模型组装链路
从 1.0 到 1.4,项目逐渐形成了下面这条可预期的处理顺序:
实时模型发现(再按需执行 provider 专属元数据增强)
  或有效缓存(已包含此前发现、过滤和增强的结果)
  → 已保存的插件模型覆盖项
  → 匹配的 provider.<id>.models 显式配置
  → 未被发现的显式模型作为独立模型保留
这个顺序的目的不是让配置变得更复杂,而是明确每类数据的责任:provider 提供当前有哪些模型;可选增强补齐 provider 知道的能力;用户的覆盖与显式配置最后表达自己的选择。
如果你正使用的服务只提供标准 /v1/models,只需启用基础发现;如果它是 vLLM、LM Studio、Bifrost 或 OmniRoute,再按需选择对应格式。没有必要为了“配置完整”开启所有增强。
完整的配置说明、缓存细节和社区 provider 示例见 GitHub 仓库。项目仍采用 MIT 协议,也欢迎通过 issue、PR 或配置示例反馈真实使用场景。
讨论