写于
LLM 的主动能力如何实现:从语言意图到受控执行
主动能力来自大模型的数学运算:它直接生成内容,或请求补充内容;客户端识别结构、控制执行,并把结果回填给下一次计算。
语言:English
上一篇《如何扬长避短地利用 LLM:为模型补上现实环境》说明了上下文、技能和工具如何让模型参与真实工作。接下来的问题是:既然模型本身只生成语言,它为什么看起来还能主动回答、挑选技能、调用工具,并把一个任务推进下去?
所谓“主动能力”并不是模型突然获得了独立意志,而是一条由模型计算与系统运行共同组成的链路:人把目标、技能和工具说明写进上下文;模型计算下一段输出的概率分布,并按解码策略产生输出;它要么直接给出内容,要么请求补充内容;客户端识别其中的结构、控制执行,并把结果作为新上下文送回模型。
主动性有两个层次:生成与语义
借用“本我”的比喻,LLM 的内生“本我”不是欲望、动机或持续存在的自我,而是它在当前上下文下计算下一个 token 概率的生成机制。人类把角色、目标和工作方法写进上下文,相当于提供一个外置的行动方向;模型再用自身的数学计算演绎这个方向。它会呈现主动性,却不会自行设定人生目标或在后台持续行动。
要理解这种主动性,可以分成两个层次:生成层解释内容是怎样被模型逐 token 算出来的;语义层解释这些内容为什么不只是在续写最后一句话,还会在任务指示下成为补充上下文、推进目标的下一步。两层是同一套模型计算的不同观察角度,不是模型中存在两个独立的“主动者”。
1. 生成层主动性:数学计算产生语言输出
把当前上下文记为 ,已经生成的 token 记为 。在第 步,模型用参数为 的函数计算隐藏状态和词表中每个候选 token 的概率:
其中 是一个候选 token。解码器随后按这个分布采样,或在给定策略下选择一个 token,得到 。新的 又被加入上下文,下一步重复同一计算。普通文字、澄清问题、JSON 中的字段、工具名与参数,都是这样逐 token 产生的。
结束也在这套机制中。许多模型的词表含有结束符(EOS);当它在当前上下文中获得足够高的概率并被选中时,服务端可以结束这一次模型输出。
更准确地说,模型并不是先理解“我已经说完了”再做判断,而是在当前上下文下为结束符分配了一个概率。与此同时,API 的最大输出长度、客户端配置的停止字符串、超时或用户中断,也可能在模型未输出 EOS 时终止生成。这些是运行时规则,不是模型自己的判断。
因此,一句模糊的“帮我处理一下”并不会自动产生可靠行动。若上下文没有说明任务目标、当前状态和可用能力,模型仍会计算并输出
看似合适的续写,但它没有足够条件让这段续写稳定地对应现实任务。
2. 语义层主动性:内容在指示下推进任务
生成层说明“输出如何出现”,却还没有说明“为什么这段内容会去补充上下文”。答案在于,上下文不仅包含前文,还包含任务对象、目标、完成标准、行为规则和可用能力。这些内容共同构成了当前语言的语义方向:什么算完成,什么证据仍缺失,哪些下一步被允许。
当模型接收到“根据当前退款政策和订单状态,准确回复用户”这样的指示,却没有看到订单状态时,直接编造一封最终答复并不能良好地延续这项任务的语义。更符合当前上下文的续写,可能是提出澄清问题、请求退款咨询技能,或生成查询订单的候选指令。
这里的主动性发生在内容的语义功能上:模型输出的不只是一个句子,而是在演绎指示所要求的下一步,并尝试补足完成任务所需的上下文。
这不表示模型独立发现了世界中客观存在的“信息缺口”,也不表示它已经验证了缺口或拥有填补它的权限。它只是从语言中的任务要求、已有证据和能力说明,计算出“先补充什么”比“现在下结论”更合适的输出。
真正读取技能、查询工具和验证结果,仍由客户端完成并回填。语义层的主动性因此不是另一种神秘能力,而是生成层的 token 概率计算在任务指示约束下,产生了具有推进作用的语言内容。
主动性如何推进任务:作答,或请求补充上下文
从客户端的角度看,这种语义上的主动推进只有两种基本形式:直接生成内容,或请求补充内容:
- 直接生成内容。 模型根据现有上下文写出答案、解释、计划或交付物。内容本身就是最基础、最常见的主动输出。
- 请求补充内容。 当现有上下文不足以稳妥地继续时,模型可以提出澄清问题,请求相关技能说明,或生成查询工具的候选调用。它们的共同作用都是让用户、技能库或工具返回新的内容,供下一轮计算使用。
这两类输出不是模型内部真的在点击两种按钮,而是客户端为不同的结构化语言赋予了不同含义。
直接生成内容与请求补充内容,本质都是计算得到的更符合任务指示的续写路径
模型根据当前上下文计算不同续写的概率分布,并按解码策略产生一种输出:若已有材料足够,它可能直接作答;若当前任务表述与已给材料使领域方法、新证据或用户澄清成为更相符的下一步,它可能请求补充内容。
这里的“需要”是语言模式和上下文约束共同产生的计算结果,不等于模型已经验证了什么是真的或已经拥有了执行权。
例如,退款咨询中,已有订单和政策信息足够时,模型可以直接起草回复;需要遵循更完整的退款流程时,它可以请求退款咨询技能说明;当前上下文未提供订单状态时,它可以请求查询订单。技能说明补充领域方法,工具结果补充现实证据;二者都服务于更准确的后续内容输出。
让能力以语言进入上下文
模型只能计算它看到的上下文。因此,系统要让它能够生成技能说明请求或工具候选调用,就需要把这些能力写成可理解的语言或结构化说明。一个技能应说明适用场景、工作步骤、所需证据和停止条件;一个工具应说明用途、输入字段和返回结果。
例如,系统可以提供这样的能力信息:
技能:退款咨询
适用:用户询问退款资格、进度或方式
步骤:读取政策 → 查询订单 → 判断是否需要确认 → 起草回复或提出受控操作
所需证据:退款政策与当前订单状态

工具:查询订单
输入:order_id
返回:支付状态、履约状态、退款资格这些说明会改变模型可计算的语言空间:在“当前上下文未提供订单状态”的情形下,查询订单 及其参数结构会成为有意义的下一步;在“政策已确认、证据齐全”的上下文里,直接起草答复会更合适。把能力写进上下文不是魔法,而是为下一 token 的概率计算提供更多相关条件。
有些系统只先提供技能目录。当当前任务使某项能力成为相符的续写时,模型可以先生成该技能说明的请求;客户端取回说明后,模型再基于新增上下文生成具体工具候选调用。这样既不必一开始塞入所有领域规则,也能让每次能力选择被观察和审查。
结构化输出让语言意图成为可识别的指令
模型输出的本质仍是 token 序列。要让程序区分普通内容与能力请求,客户端需要约定一个可识别的格式,例如 JSON、函数调用字段或受限指令:
{
  "type": "tool_call",
  "name": "lookup_order",
  "arguments": { "order_id": "A-1024" },
  "reason": "需要确认订单是否符合退款条件"
}
这不是模型直接调用了 lookup_order。它只是像生成一段普通文字一样,生成了一段符合约定结构的 token。客户端读取 type、name 和 arguments 后,才知道这段输出应被当作候选工具请求,而不是直接展示给用户的回答。
同一个模型输出协议也可以表示“请求某项技能说明”或“向用户提问”;它们都属于请求补充内容。“任务完成”则是客户端读取输出后得到的任务状态信号,不属于这两类推进任务的输出;它与 EOS 一样,都是控制循环是否继续的依据。结构化输出的价值,是把语言中的下一步意图变成系统可以识别、记录和路由的候选指令;它让主动性能够进入程序流程,而不把语言模型误当成直接操作系统的主体。
执行权不随语言意图转移。 结构化输出只把模型生成的内容标记为候选指令;是否读取信息、调用工具或执行动作,仍由客户端和运行时规则校验并决定。拒绝、错误和新结果同样会成为下一轮计算的上下文。
客户端把输出接成运行循环
模型的主动能力通常不是一次性完成的,因为每次新证据都会改变下一次的概率计算。客户端负责把这些输出接成循环:
- 接收用户目标,准备任务背景、已有状态以及可用技能和工具说明。
- LLM 计算并生成直接内容,或以澄清问题、技能说明请求、工具候选调用等形式请求补充内容;EOS 作为独立的生成结束事件,表示这一段输出停止。
- 若是直接内容,客户端可以展示给用户;若是补充内容请求,客户端向用户获取回答、读取相应技能说明,或把工具候选请求交给受控执行层。
- 执行层返回结果、错误或状态变化;客户端把它们连同当前任务状态重新送入模型上下文。
- 模型在新上下文中再次计算,继续输出、提出问题或请求能力;客户端再根据 EOS、任务状态和运行时规则决定是否结束循环。
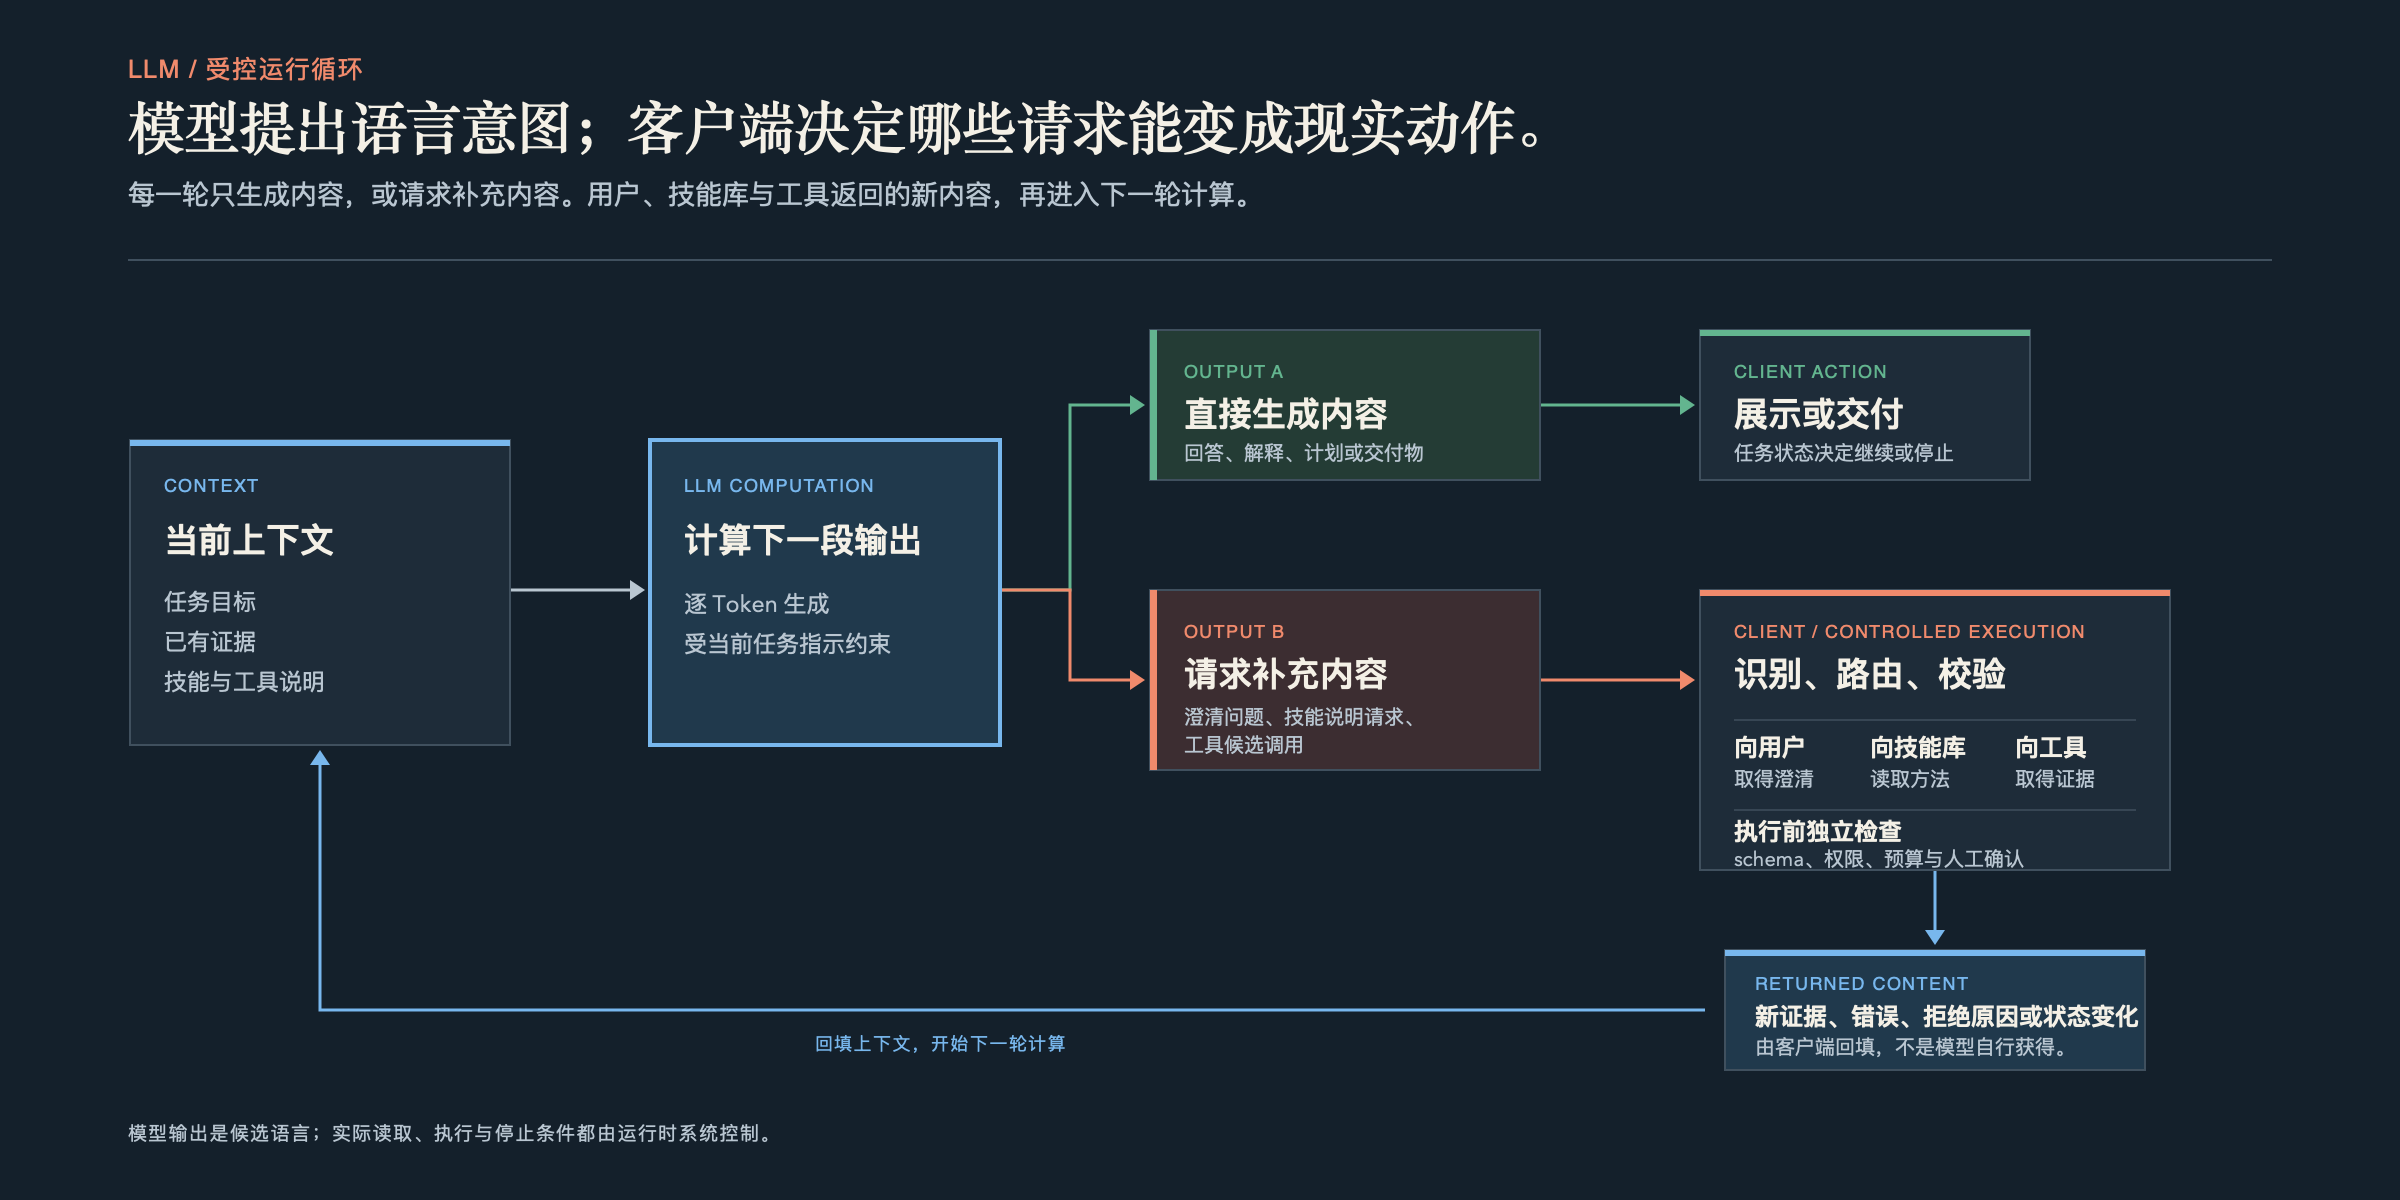
以退款咨询为例:当前上下文未提供订单状态时,模型可以生成查询订单的结构化候选调用;客户端执行查询后回填“订单已签收、仍在退款期限内”。模型获得新证据后,可以直接解释退款资格,也可以在用户明确要求退款时生成另一条受控动作的候选调用。每一轮看起来像“主动决定”,实际都是当前上下文经由模型函数产生的下一段输出。
停止条件让循环不会变成漫游
token 层面的结束符与任务层面的停止条件并不是同一件事。EOS 只意味着这一段模型生成结束;任务是否已经完成,还需要客户端结合目标与运行状态判断。
一个能继续行动的系统,也必须知道何时不再行动。常见条件包括:
- 已满足验收标准,结果足以交付;
- 缺少关键输入,需要向用户提出一个明确问题;
- 没有已授权的能力能够解决当前缺口;
- 达到步骤、时间、成本或重试上限;
- 下一步不可逆或会影响他人,必须等待人工确认;
- 工具反复失败,继续尝试已不再提供新信息。
客户端应把这些条件实现为运行时规则,而不是仅靠模型“记得遵守”。它可以阻止未授权工具、拒绝超出预算的调用、在循环次数达到上限时终止,并记录每次模型输出、校验和执行结果。
用主动能力时,检查这五件事
想把语言生成变成可靠的主动工作流,可以从五个问题开始:
- 生成机制是否说清楚? 是否区分了模型对 token(包括 EOS)的概率计算,与客户端施加的停止规则?
- 两类输出是否明确? 系统是否能区分直接内容与补充内容请求,并识别后者是向用户、技能库还是工具索取内容?
- 能力是否说清楚? 技能和工具是否写明用途、输入、证据与停止条件?
- 意图与执行是否分离? 模型输出是否采用客户端可识别的结构,且执行层是否独立检查权限、参数、成本和人工确认?
- 反馈与任务停止是否明确? 每次结果、错误和拒绝是否回到上下文;系统是否知道何时交付、提问或停止?
当这些条件具备时,LLM 的数学语言生成就能参与多步工作:
- 它用当前上下文直接生成下一段内容,或请求技能说明、现实证据、用户澄清等补充内容;
- 客户端再以受控方式取得或执行这些请求所需的结果,并把结果交回下一次计算;
- 继续循环,直到满足停止条件。
真正实现主动能力的不是一句“请自主完成任务”的提示词,而是模型函数、上下文、客户端与工具共同组成的一套可观察、可约束的运行过程。
讨论